회사 소개
세일즈포스(Salesforce)는 고객관계관리(CRM)를 중심으로 기업용 애플리케이션과 데이터·AI 플랫폼을 제공하는 글로벌 소프트웨어 기업입니다. AI 에이전트가 기업의 업무를 이해하고 안전하게 실행할 수 있도록, 데이터와 업무 맥락, 보안 및 거버넌스를 연결하는 ‘엔터프라이즈 AI 하네스(Enterprise AI Harness)’를 구축하고 있습니다.
인터뷰이 소개
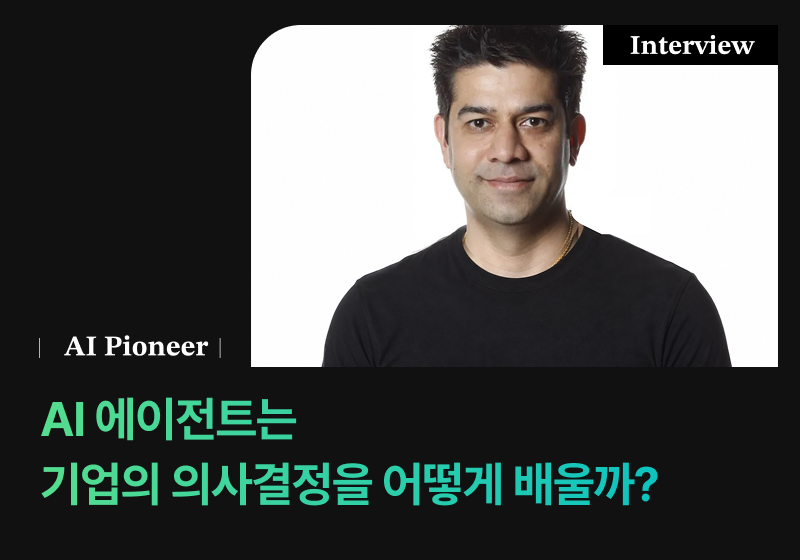
로한 쿠마르(Rohan Kumar)는 세일즈포스의 사장 겸 최고 플랫폼·엔지니어링 책임자입니다. 글로벌 엔지니어링 조직과 세일즈포스 플랫폼을 이끌고 있습니다. 이전에는 마이크로소프트에서 20년 이상 근무하며 Azure Data와 Microsoft Security 부문 부사장 등을 역임했고, 기업용 데이터 플랫폼과 클라우드, 보안 분야에서 경험을 쌓았습니다.
Q. 당신은 마이크로소프트에서 개발자들이 쓰는 데이터 인프라를 오랫동안 만들어왔습니다. 그런데 지금 Salesforce에서는 AI 에이전트가 그 인프라 위에서 직접 행동을 하죠. 사람을 위한 툴을 만드는 것과 에이전트를 위한 인프라를 만드는 것은 어떻게 다른가요?
일반적인 에이전트 생애주기는 다른 소프트웨어와 크게 다르지 않습니다. 에이전트를 만들고, ‘골든 셋(Golden Set)’이라고 부르는 평가 세트를 만듭니다. 특정한 질문에 대한 정답을 미리 정해두고, 에이전트가 그 답을 얼마나 잘 내놓는지로 성능을 측정하는 방식이니까요.
하네스(Harness)를 정의할 때도 보통은 여기서 크게 벗어나지 않습니다. 에이전트가 실행되는 런타임은 무엇인지, 어떤 API를 호출하고 어떤 응답을 받는지, 그 응답이 올바른지 어떻게 측정할지 같은 것들이죠.
그런데, Salesforce에서 말하는 ‘엔터프라이즈 AI 하네스’는 그보다는 훨씬 넓은 개념입니다. 에이전트를 실행하고, 작성하고, 평가 세트로 테스트하는 것은 그저 출발점에 불과합니다. 그 위에 두 가지가 더 얹혀야 하거든요.
첫째는 관리입니다. 기업 내에서는 매일같이 새로운 에이전트가 추가되기도 하고 기존에 쓰던 에이전트를 비활성화하기도 합니다. 이런 변화를 한눈에 파악할 수 있는 중앙 레지스트리가 있어어 하고, 이런 상태를 지속적으로 스캐닝해야 합니다.
둘째는 보안입니다. 요즘 만들어지는 에이전트 대부분은 특정 사용자를 대신해서 실행됩니다. 문제는 에이전트의 신원이 그 사용자의 신원을 그대로 가져간다는 점, 즉 사용자가 가진 모든 권한을 에이전트도 갖게 되는 셈이라는 겁니다. 그래서 에이전트 전용의 신원(Identity)을 별도로 만들고 권한을 제한하는 작업이 필요합니다. 에이전트가 오작동하거나 예상치 못한 방향으로 움직이더라도, 기업의 기밀 데이터가 외부로 새나가는 일은 막아야 하니까요.
Q. AI 에이전트를 도입하는 기업들이 흔히 저지르는 실수가 있다고 이야기하신 적이 있죠. 바로, 모든 데이터를 일단 다 연결하고 에이전트한테 알아서 찾으라고 던져버리는 식의 접근이요. 이런 식으로 작업을 하면, 에이전트의 토큰 비용이 폭발적으로 늘어날 수 밖에 없을 겁니다. 이런 상황을 막으려면, 엔지니어링적으로 어떻게 접근해야 하나요? 다른 모델을 쓰거나, 작업 스케줄을 나누는 방식인가요?
데이터라는 관점에서 먼저 짚고 싶은 게 있습니다. 기업의 가장 중요한 자산은 물론 데이터이고, 지식도 바로 거기서 나옵니다. 그런데 어떤 데이터가 극도로 민감한지, 그 데이터로 에이전트가 무엇을 할 수 있는지는 에이전트를 개발하는 영역 바깥에서, 별도의 AI 정책으로 관리되어야 합니다.
효율성 문제도 빠질 수 없습니다. ‘토큰 맥싱(Token Maxing)’이라는 말 들어보셨을 텐데, 엔지니어링 현장에서 자주 나오는 접근이죠. SaaS 애플리케이션이든, 데이터 웨어하우스든, 데이터 레이크든 전부 커넥터로 연결하고 에이전트에 프롬프트를 던져놓고 알아서 찾게 하거나, AI 도구의 요금제를 풀어놓고 회사 직원들에게 ‘한 번 마음껏 써 봐’ 하는 식이죠. 너무나 당연하게도, 토큰 예산이 순식간에 터져 나갑니다.
이 문제를 해결하기 위해서 이야기되고 있는 것이, 보통 하네스와 관련해서 언급되는 신뢰 컨텍스트 레이어(Trusted Context Layer)입니다. 이 레이어에서는, 관련된 작업이 CPU·GPU 사용이 적은 시간대, 예를 들어 기업 시스템이 한산한 밤 11시부터 새벽 5시 사이에 백그라운드에서 미리 돌린다든지 하는 의사결정을 할 수 있습니다. 데이터 자산을 순회하면서 정리하고, 시맨틱 모델을 만들고, 비즈니스 도메인에 맞는 온톨로지를 구성하는 프로세스도 자동으로 실행되구요. 그게 저희가 신뢰 컨텍스트로 그리는 비전이라고 할 수 있습니다.
요즘 ‘모델 라우팅(Model Routing)’이라는 개념도 뜨고 있습니다. 고객들한테서도 자주 듣는데, 프론티어 모델은 보통 대부분의 작업을 할 때 너무 비싸다는 거예요. “마트 가는 데 페라리 몰 필요 없다”는 비유가 딱 맞는 상황인 거예요.
CIO나 데이터 리더, 개발자들이 원하는 건 결국 이겁니다. ‘우리가 원하는 결과를 설명해주면, 하네스가 가격 대비 성능이 가장 좋은 모델을 알아서 골라줄 수 있느냐’ 하는 거예요. 데이터베이스 세계에서는 오래전부터 가격 대비 성능비를 따졌는데, 그 개념이 이제 모델에도 들어오는 거라고 이야기할 수도 있겠습니다. 돈을 더 많이 내고 더 좋은 성과를 낼 수도 있지만, 그런 차이가 필요없다면 돈을 덜 쓰고 싶다는 거고, 이 개념이 하네스 – 또는 신뢰 컨텍스트 레이어 (꼭 하네스에 들어있을 필요는 없음)에 녹아들게 될 겁니다.
결국 가장 어려운 건, 소위 말하는 ‘엔터프라이즈 컨텍스트’를 합성하는 일입니다. 데이터가 데이터 레이크, 데이터 웨어하우스, 스토리지 시스템, 멀티 클라우드, SaaS 애플리케이션 등 온갖 곳에 흩어져 있고, 스키마도 제각각에 정형·비정형 데이터들이 뒤섞여 있습니다. 이걸 지금 다들 지식 그래프(Knowledge Graph)라고 부르는 형태로 정규화하는 게 과제라는 거죠.
데이터 구조는 크게 세 가지입니다. 레이크 안에 Delta, Parquet, Iceberg 같은 표준 포맷의 비정형 데이터가 있고, 관계형 테이블도 있고, 여러 시맨틱 모델에 걸쳐서 관계를 노드와 엣지로 표현하는 지식 그래프가 있습니다. SaaS 애플리케이션 대부분이 관계형 테이블 위에 올라가 있는데 Salesforce 객체들도 마찬가지입니다. 에이전트가 지식 그래프 레벨에서 작동하면 훨씬 효율적으로 자신이 해야 할 일을 이해할 수 있습니다.
에이전트를 이야기할 때 제가 쓰는 분류 체계는 세 가지입니다. 첫째는 코드— 에이전트가 실행하는 코드인데, 코딩 에이전트가 워낙 많다 보니 점점 범용화되고 있습니다. 둘째는 모델 인텔리전스, 모델에서 나오는 범용 지능입니다. 셋째는 신뢰 컨텍스트, 고객의 비즈니스 자체에 대한 이해이구요.
이 세 가지가 합쳐져야 에이전트가 진짜 높은 효율로 작동합니다. 가장 어려운 건 당연히 ‘비즈니스 이해’예요. 모델은 범용으로 만들어지니까요. 어제 발표한 ‘xGen Korea’를 예로 들면, 지난 28년간 CRM 프론트오피스 제품에서 쌓아온 것과 10년간의 데이터·AI 연구를 집어넣은 Salesforce 최초의 CRM 추론 모델입니다. 그런데 CRM 모델이라고 해도 사실은, 결국은 범용 CRM 모델입니다. 반드시 기업별로 엔터프라이즈 컨텍스트와 짝을 이뤄야만 제 기능을 할 수 있습니다.
하나 더 말씀드릴 한계라고 할까, 그런게 있다면, 기업 안에 데이터는 넘쳐나지만, 의사결정 방식을 들여다보면 구조 자체가 없는 경우가 대부분이라는 겁니다. “미팅이 있었고, 팀장님과 줌이나 팀즈, 슬랙 허들로 얘기하고 결정을 내렸다.”는 식이 대부분인데, 어딘가에 기록이 남는다면 기껏해야 통화 녹취록 정도입니다. 의사결정이 이루어지는 방식에는 비결정론적인 요소가 너무 많습니다.
Q. 정말 어렵고도 미묘한 문제네요. 그 결정의 맥락과 이유를 어떻게 포착해서 에이전트가 읽을 수 있는 형태로 만들 수 있을까요?
말씀대로, 에이전트가 빠르게 확산되기 위해 필요한 진짜 돌파구는, 그런 데이터나 정보를 어떻게 포착해서 에이전트가 읽을 수 있는 형태로 만드느냐입니다. 에이전트가 호출할 수 있는 API로 어떻게 구현하느냐는 거죠. 쉽지 않은 문제이고, 저희의 현재로서의 비전은 하네스를 만드는 과정에서 그 해법을 찾고 앞으로 그런 데이터를 모아서 에이전트가 활용하고 학습할 수 있도록 하는 거라고 말씀드릴 수 밖에 없을 것 같습니다.
Q. 엔지니어한테는 판단력과 감각, 말하자면 수십 년 경험에서 나오는 직관 같은 게 있을 거라고 생각하는데요. 그런데 그게 코드로 명시적으로 표현되지는 않죠. 그런 건 에이전트한테 어떻게 가르칠 수 있나요?
모든 모델은 결국 생산된 코드로부터 학습합니다. 엔지니어들은 코드를 만드는 과정에서 경험과 창의성을 발휘하고, 그게 코드로 구현됩니다. 코딩 모델을 사전 학습할 때 그 코드를 전부 들여다보는데, 가장 어려운 컴퓨터 공학의 문제들이 이미 코드로 풀려 있어서 모델이 그 사례를 보고 학습하고 따라할 수 있습니다. 코딩 모델이 이렇게까지 강력해진 이유가 바로 그래서인 거죠. 코딩에는 그런 정보, 통찰 같은 것들이 코드에 녹아 있다는 거예요.
반면에, 대부분의 비즈니스 의사결정은 구조화돼 있지도 않고 어딘가에 녹아 있지도 않아요. 의사 결정이 어떻게 이루어지는지를 보여주는 코드 같은 게 없다는 겁니다. 팀 미팅 녹화본이나 통화 기록 어딘가에 흩어져 있을 뿐이고, 너무나도 비결정론적입니다. 우리에게 필요한 기술적 돌파구는, 반복해서 말씀드리지만, 비즈니스가 어떻게 작동하는지를 에이전트가 API를 통해 학습할 수 있는 구조로 만드는 것입니다. 아직 풀리지 않은 문제지만, 이게 풀리는 순간 판도가 바뀌게 될 겁니다.
Q. 그 돌파구가 어디서 올 거라고 보세요? 새로운 연구인가요, 새로운 접근법인가요, 아니면 아키텍처 자체가 바뀌어야 하나요?
개인적인 생각으로는, 엔지니어링이 진행되는 방식 자체가 바뀌어야 합니다. 대형 회사들은 제품을 만들고, 베타 테스트를 하고, 전통적인 소프트웨어 개발 생애주기의 단계를 밟아나갑니다. 저는 앞으로의 제품, 앞으로의 소프트웨어는 ‘고객과 함께 만들어야 한다’고 봅니다. 말 그대로 고객 옆에 앉아서 의사결정이 어떻게 이루어지는지 이해하고, 매일매일 어떤 일이 어떻게 돌아가는지 배워야 합니다. 고객과의 긴밀한 통합이 반드시 필요합니다.
Q. 마지막으로, 이 AI 시대에 커리어를 시작하는 주니어 엔지니어들한테 어떤 말을 해주고 싶으세요? 일각에서는 AI가 워낙 강력해져서 이제 시니어 몇 명만 있으면 된다고도 하는데, 그렇게 되면 주니어가 경험을 쌓을 자리 자체가 없어지는 거 아닌가요?
지금 대세를 이루고 있는, ‘AI가 있으니 주니어가 필요없다’는 식의 내러티브가 놓치고 있는 건, ‘누군가는 어딘가서부터 시작해야 한다’는 겁니다. 그리고, 코딩이 아무리 쉬워지더라도 분석적 사고는 정말 중요합니다. 결과물이 맞는지 틀린지 판단하는 예술적 감각과 안목, 그걸 갖춰야 합니다.
기초는 변하지 않습니다. 모델이 글을 아무리 잘 쓴다고 해서 문법을 배울 필요가 없어지는 건 아니잖아요. 전부 외주로 줘버리면 자기가 뭔가를 쓸 수 있겠습니까? 지금은 창의성 쪽으로의 이동이 일어나고 있습니다. 코드를 생산하는 건 자동화되고 있지만, 그걸 가지고 무엇을 하느냐가 중요합니다. 도전할 수 있는 문제의 범위가 갑자기 훨씬 넓어졌어요. 생명과학이나 더 큰 과학적 문제들까지도요. 그런데 그런 문제도 기초를 이해해야 풀 수 있습니다. 이 모든 것의 근간이 되는 수학, 아이들이 반드시 배워야 한다고 생각합니다.